
WHITEPAPER · ABRIL 2026
El gap de medición.
Un framework para observabilidad de código IA en empresas
Para CTOs, VPs de Ingeniería y CIOs responsables de los resultados de la inversión en IA.
- 93,9%la IA frontier supera a los humanos (SWE-bench)
- 42%de todo el código es ahora generado por IA
- 0%de las orgs puede atribuir código IA por agente
Sección 1
Resumen ejecutivo
El 42% de todo el código entregado es ahora generado por IA[1]. Los últimos modelos frontier ya obtienen un 93,9% en SWE-bench Verified — superando a los desarrolladores humanos en la resolución de bugs reales de producción[2]. Sin embargo, prácticamente ninguna organización puede decirte qué agente escribió qué línea, ni si ese código sobrevivió una semana en producción. El gap no es la tecnología — es la ausencia de observabilidad.
Las plataformas de inteligencia de ingeniería estándar (DX, LinearB, Faros) miden actividad a nivel de equipo: cycle time, frecuencia de despliegues, velocidad de PRs. Ninguna mide qué fracción de un commit fue escrita por IA, qué agente la produjo, ni si ese código sobrevive en producción.
Sin atribución por línea, tres preguntas críticas quedan sin responder:
Este paper propone un framework de medición basado en tres KPIs (Adopción, Durabilidad, Reescritura de código) y un estándar abierto (git-ai v3.0.0) para capturar atribución IA por línea en el momento del commit. El enfoque es local-first, portable entre proveedores, y compatible con las plataformas de inteligencia de ingeniería existentes.
¿Cuánto del código que entregamos lo escribió una IA?
¿Ese código sobrevive — o genera retrabajo?
¿Qué proveedores y equipos usan IA con más eficacia?
Sección 2
El estado de la codificación IA en 2026
La codificación IA ya no es un piloto — es infraestructura de producción. El 42% de todo el código es ahora generado por IA[3]. Los modelos frontier superan a los desarrolladores humanos en resolución de bugs reales. La pregunta ya no es "¿deberíamos usar IA?" sino "¿qué IA, y cómo lo demostramos?"
- 93,9% — SWE-bench Verified — IA frontier vs 67–70% baseline humano[4]
- 90% — del Fortune 100 ha desplegado GitHub Copilot[5]
- 3–4x — productividad en Goldman Sachs con coding IA agéntico[6]
- 42% — de todo el código es ahora generado o asistido por IA[3]
- 280K — horas de desarrollador ahorradas por DevGen.AI de Morgan Stanley en 5 meses[7]
- $7,6B — mercado de herramientas de código IA en 2025 — proyectado $26B para 2030[8]
Sección 2b
Adopción empresarial por sector
Las herramientas de código con IA ya no son pilotos experimentales. Son infraestructura de producción en las mayores organizaciones del mundo. El 90% del Fortune 100 ha desplegado solo GitHub Copilot[9]. Pero la profundidad de adopción varía dramáticamente por sector.
Fuentes: GitHub Blog, JetBrains 2025, informes públicos, GOV.UK AICA trial
| Sector | Adopción |
|---|---|
| Fortune 100 | 90% |
| Tecnología / SaaS | 85% |
| Banca | 78% |
| Gobierno | 45% |
| Todos los desarrolladores | 82% |
Sección 2c
Lo que dicen los analistas
Todas las grandes firmas de analistas han publicado sobre IA en ingeniería de software. El consenso: la adopción es inevitable, pero la medición y la gobernanza van peligrosamente por detrás.
Trayectoria de adopción y proyecciones de mercado
- 14%Ingenieros enterprise — usando IA (Gartner) (2024)
- 82%Desarrolladores usan IA — semanalmente (JetBrains) (2026)
- 90%Predicción Gartner: — adopción enterprise (2028)
- 80%Equipos más pequeños — aumentados con IA (Gartner) (2030)
- $7.6BMercado AI code tools — (2025)
- $26BMercado proyectado — (2030, 27% CAGR)
- $91BMercado proyectado — (2035, Precedence)
Fuentes: Gartner, Grand View Research, Precedence Research, JetBrains 2025
La paradoja de la productividad (DORA 2025)
MÉTRICAS INDIVIDUALES (SUBEN)
- +21%tareas completadas
- +42%código generado por IA
- +98%PRs mergeadas
- 30–60%tiempo ahorrado codificando
MÉTRICAS ORG (PLANAS / BAJAN)
- 0%mejora en entregas
- 4xduplicación de código
- −7.2%estabilidad de entregas
- 2xreescritura de código (proyección 2026)
Fuentes: DORA Report 2025, Sonar Developer Survey, ByteIota 2026
Sección 2d
El imperativo regulatorio
La presión regulatoria converge sobre el código generado por IA desde tres direcciones: el EU AI Act, el compliance financiero (SOX/SOC 2) y los mandatos emergentes de calidad de código. Las organizaciones que no puedan identificar qué código fue generado por IA enfrentarán hallazgos de auditoría, brechas de compliance y bloqueos de contratación en los próximos 18 meses.
Cronograma de aplicación del EU AI Act
ESTÁS AQUÍ
- Febrero de 2025Febrero de 2025 — Prácticas prohibidas — EU AI Act
- Agosto de 2025Agosto de 2025 — Reglas modelos GPAI — aplican
- Agosto de 2026Agosto de 2026 — Aplicación completa — Transparencia + marcado
- Agosto de 2027Agosto de 2027 — Sistemas alto riesgo — compliance completo
Sección 3
El gap de medición
Las organizaciones de ingeniería llevan una década invirtiendo en plataformas de medición. Métricas DORA, framework SPACE, scores DXI. Ninguna mide la autoría IA.
Solo el 16,8% de las organizaciones rastrea inversión por herramienta IA frente a beneficio[8]. Del 83,2% restante, la mayoría confía en encuestas a developers, feedback anecdótico, o ninguna medición. Cuando el board pregunta si el presupuesto de IA está dando resultado, la respuesta honesta es "no lo sabemos".
| Categoría de plataforma | Qué rastrea | ¿Mide IA? |
|---|---|---|
| Engineering intelligence (DX, LinearB, Faros) | Cycle time, throughput, velocidad de PRs, DORA | No |
| Calidad de código (SonarQube, Code Climate) | Análisis estático, cobertura de tests, complejidad | No |
| Gateways IA (proxies LLM) | Consumo de tokens, coste de API | Solo entradas |
| Encuestas a developers | Satisfacción auto-reportada | Subjetivo |
| Observabilidad de código IA (Iria Monitor, git-ai) | Atribución por línea, durabilidad, reescritura | Sí |
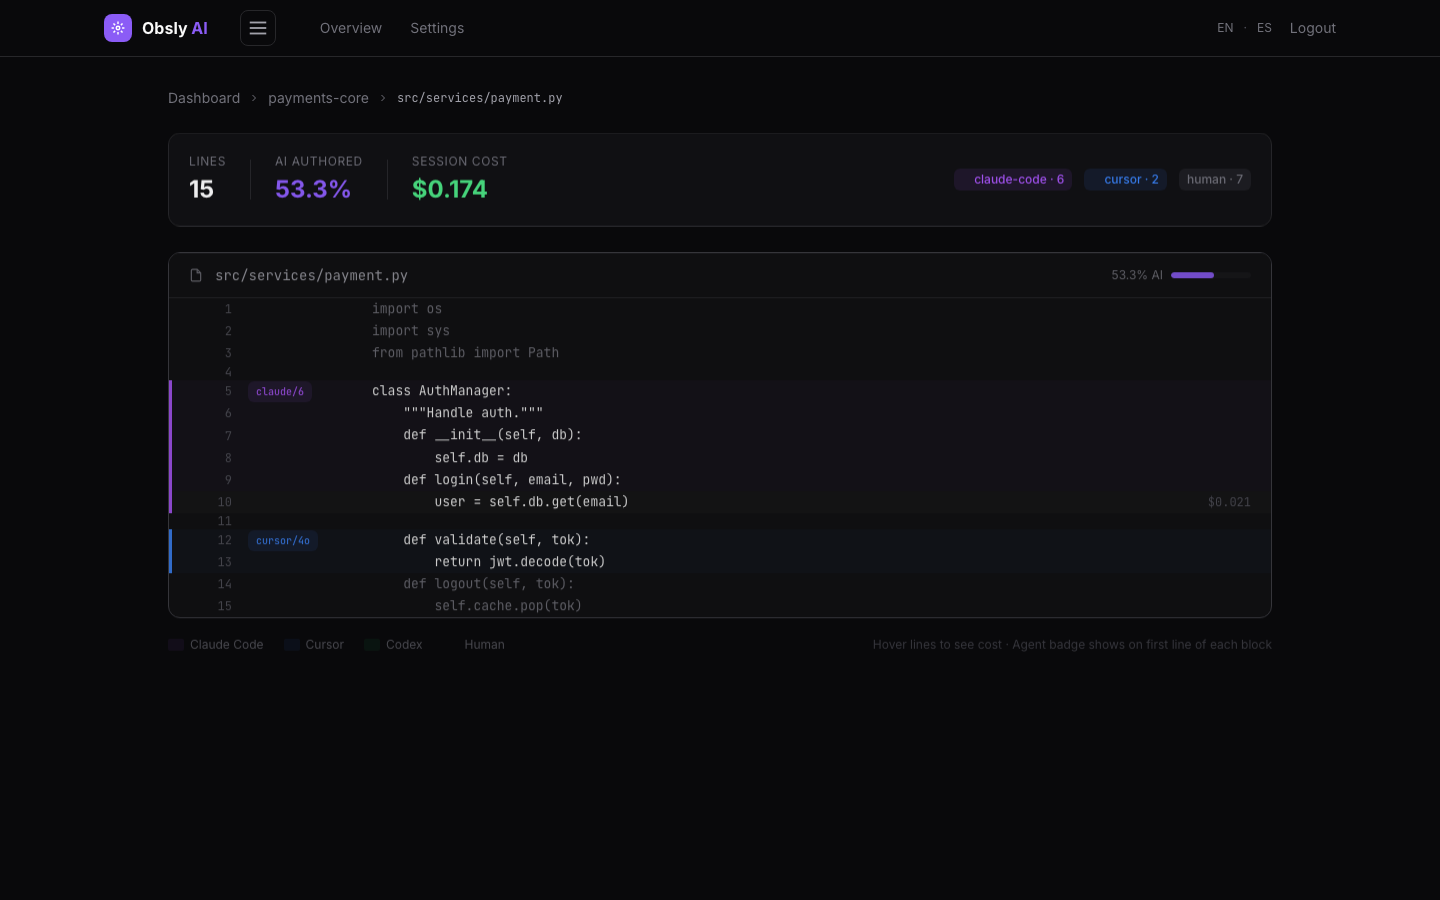
El gap no está en los datos — git ya almacena todo lo necesario. El gap está en capturar la autoría IA en el momento de la creación, antes de que la señal desaparezca.
Sección 4
Un framework para observabilidad de código IA
El framework se basa en tres principios:
PreToolUse y PostToolUse cuando editan archivos. Capturar el diff en ese momento es determinista. La detección a posteriori (clasificadores IA sobre diffs) tiene <60% de precisión.refs/notes/ai como git notes estructuradas siguiendo el estándar abierto git-ai v3.0.0. Los datos viajan con el código, sobreviven a rebases vía post-rewrite hooks, y son accesibles a cualquier herramienta que lea git.- MÁQUINA DEL DESARROLLADOR
- Agentes IA
- Claude Code · Cursor
- Codex · Windsurf
- hooks
- iria-monitor CLI
- calcula el diff
- atribuye líneas
- refs/notes/ai
- git-ai v3.0.0
- estándar abierto
- git push (solo metadatos, sin código fuente)
- IRIA MONITOR CLOUD · OPCIONAL
- Agregación
- · Por proveedor
- · Por repositorio
- · Por desarrollador (privado)
- KPIs
- Adopción
- Durabilidad
- Reescritura de código
- Exportar
- PDF · CSV · BI
Sección 5
Tres KPIs que importan
La atribución por línea es la base, pero el valor viene de tres métricas derivadas. Estos son los números que un CTO debería poder recitar para cualquier trimestre, repositorio o proveedor.
Adoption = (lines AI-attributed) / (total lines added) × 100La adopción por sí sola no es una métrica de calidad. Un proveedor al 80% de IA puede estar funcionando mejor o peor que uno al 30%. El valor de la Adopción es contextual: establece el denominador para los otros dos KPIs.
Benchmark de la industria: Los equipos saludables operan entre el 25–40%. Por encima del 40%, las tasas de retrabajo aumentan 20–25%[7].
Durability(30d) = (AI lines unchanged 30 days later) / (AI lines added) × 100La métrica más importante. La durabilidad separa el código IA valioso del retrabajo. Una línea que sobrevive 30 días en producción mereció ser generada. Una línea reescrita la misma semana no — consumió tokens, tiempo de revisión y confianza.
Por qué importa: Dos proveedores con 70% de Adopción pueden tener resultados muy diferentes. Uno con 90% de Durabilidad está aportando valor. Uno con 55% está generando retrabajo que pagas dos veces.
Churn(7d) = (AI lines rewritten by human within 7 days) / (AI lines added) × 100La reescritura de código es la señal inversa de Durabilidad y el indicador adelantado de problemas. Una reescritura alta significa que los humanos están corrigiendo sistemáticamente el output IA. Apunta a elección de herramienta equivocada, prompts equivocados, o domain fit equivocado.
Valor diagnóstico: La reescritura segmentada por agente revela si el problema es la herramienta (Cursor 18% vs Claude 6% en el mismo repo) o el developer (un equipo 4%, otro 22% con el mismo agente).
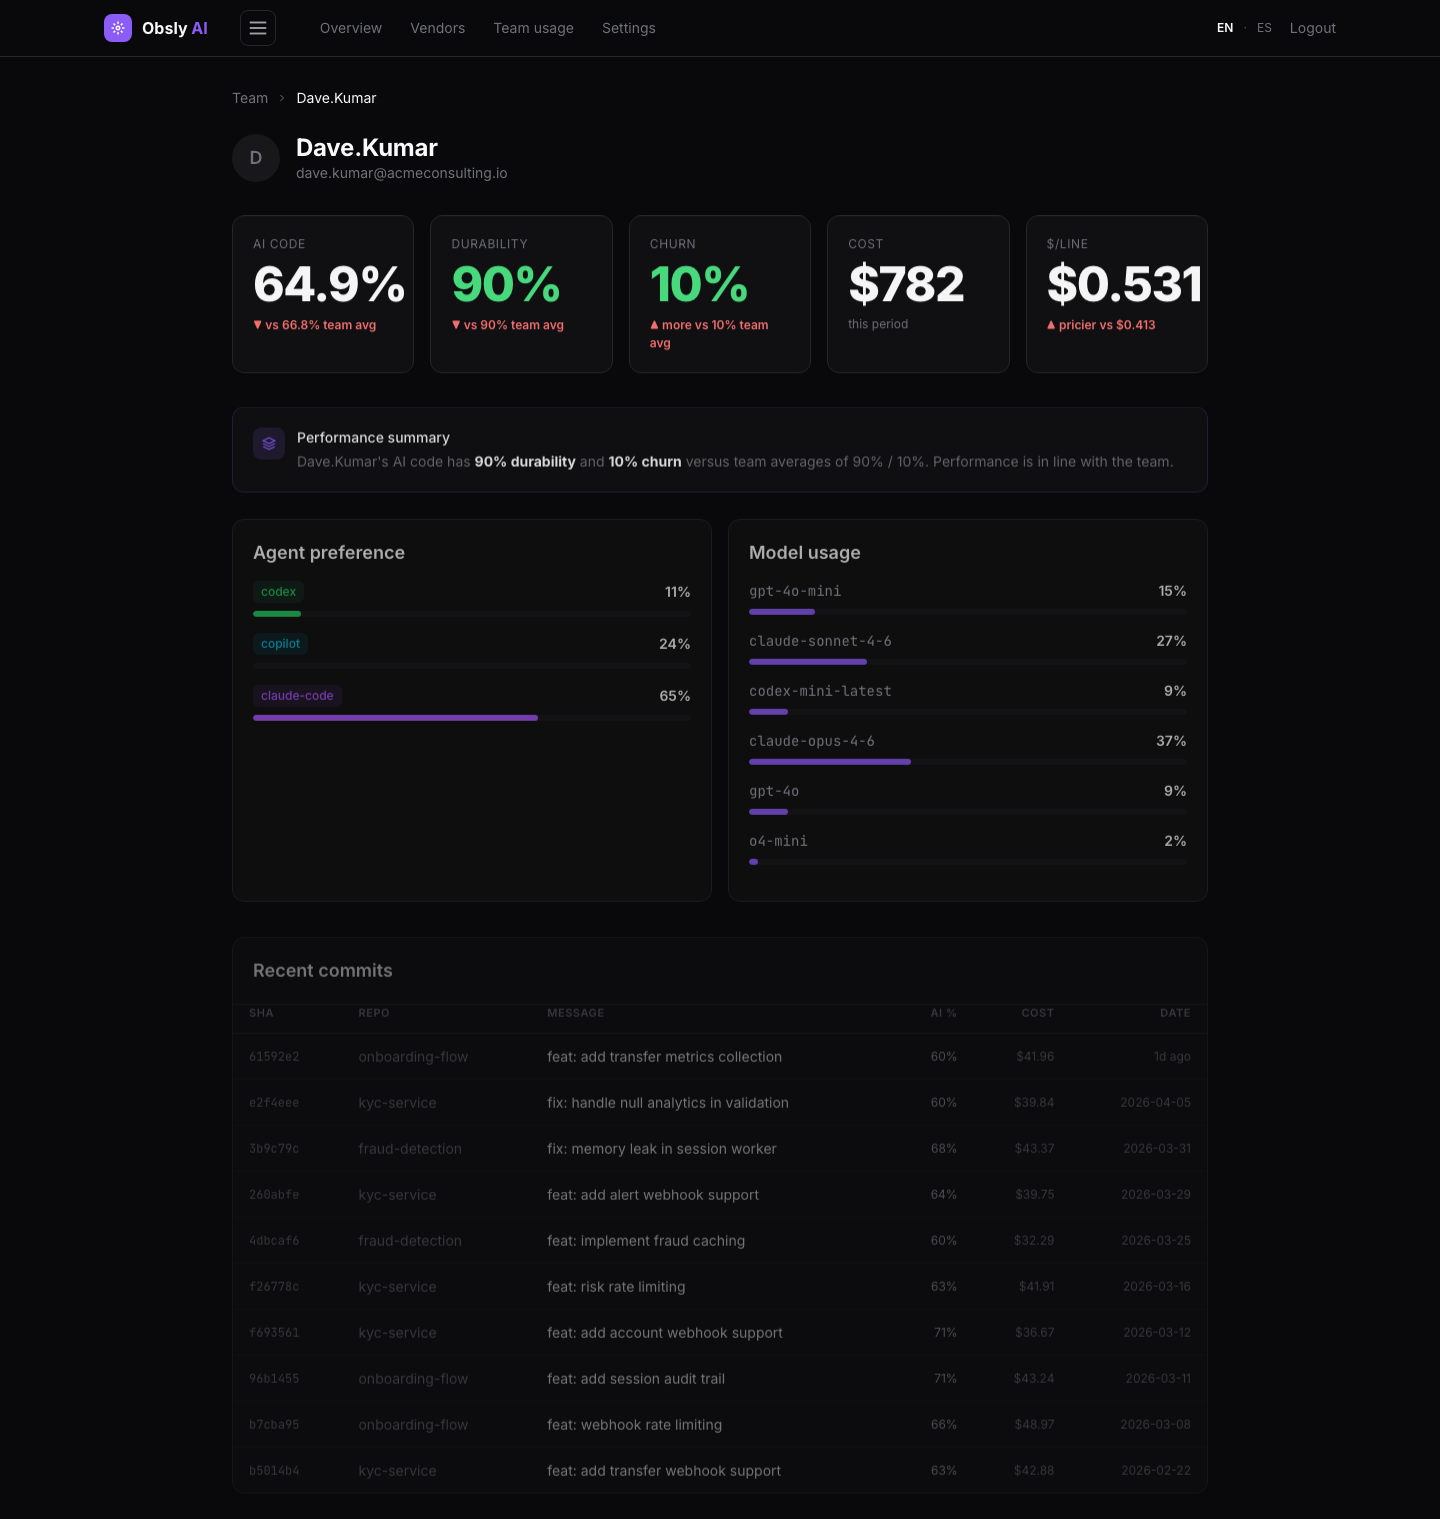
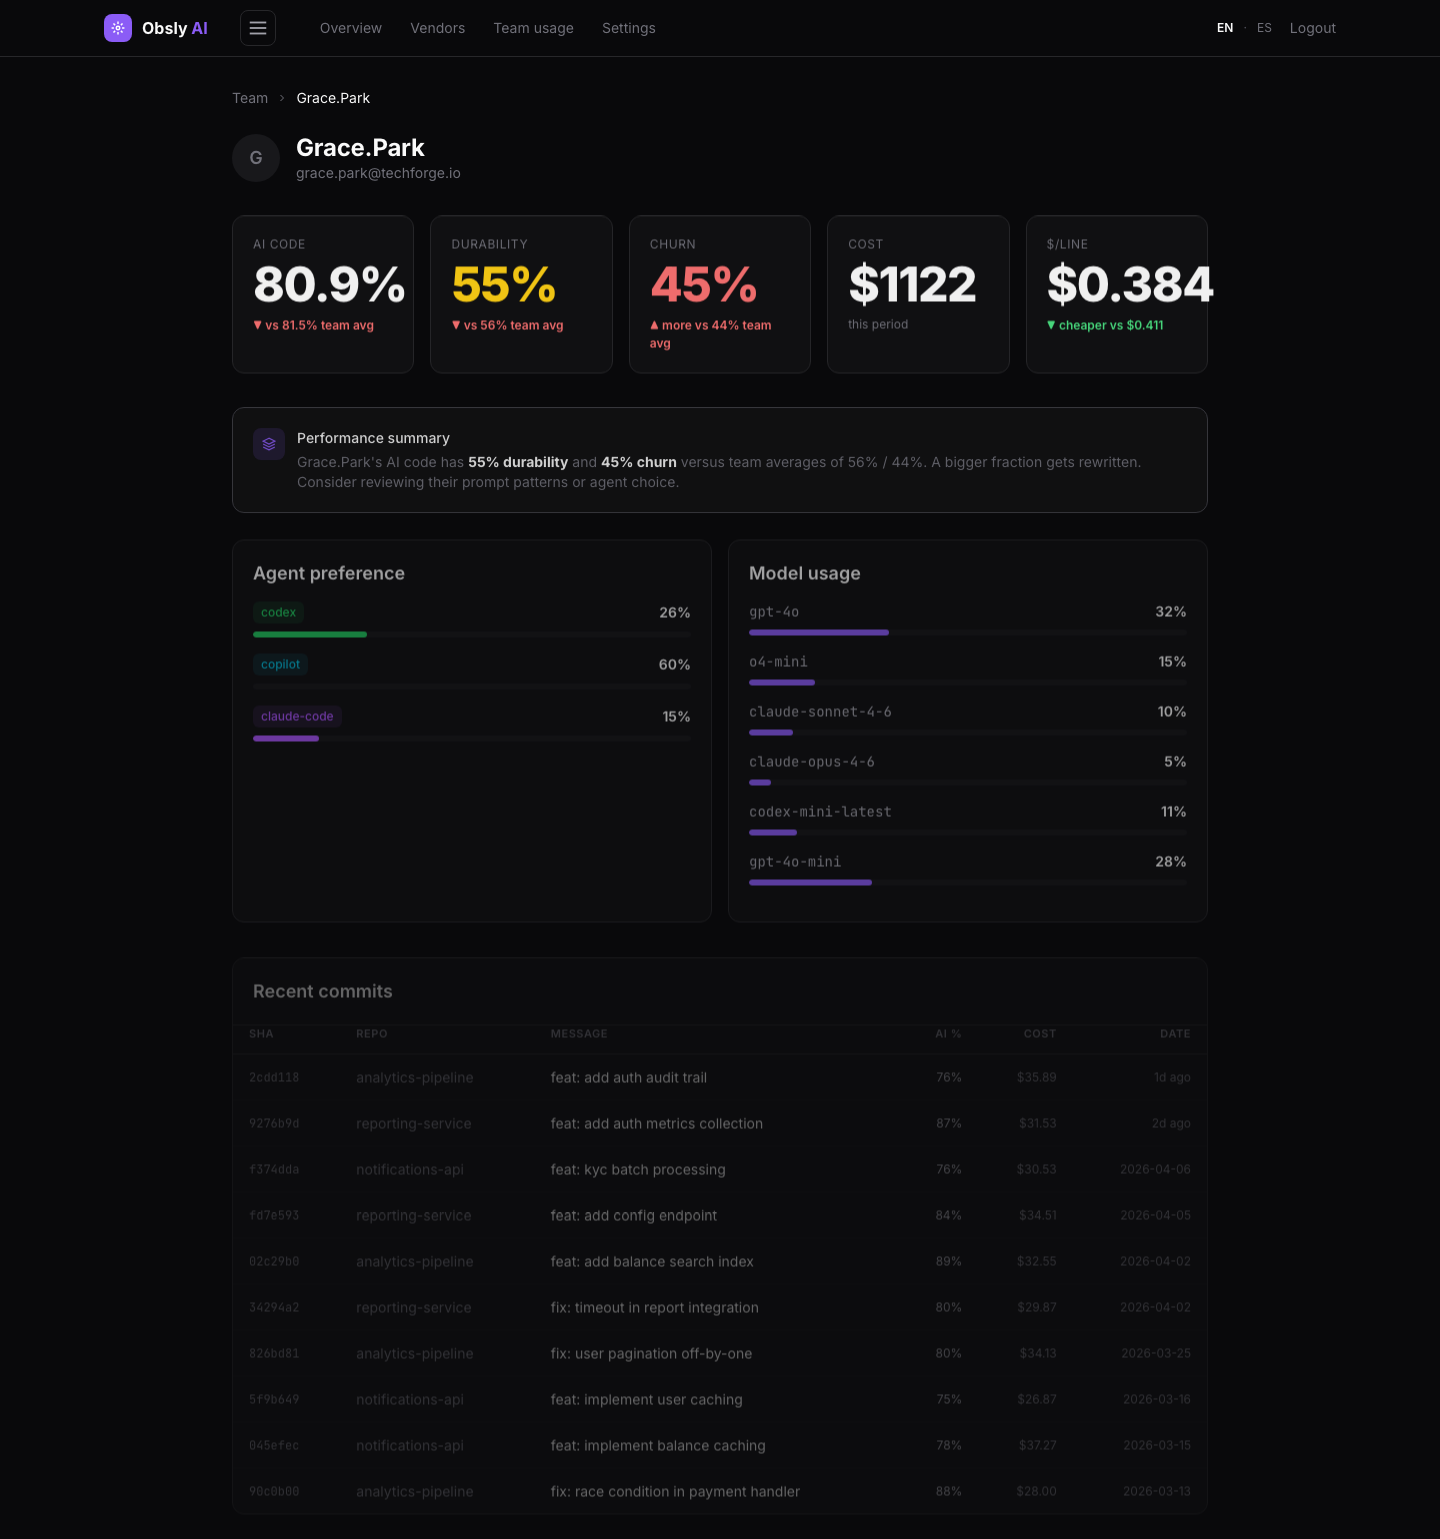
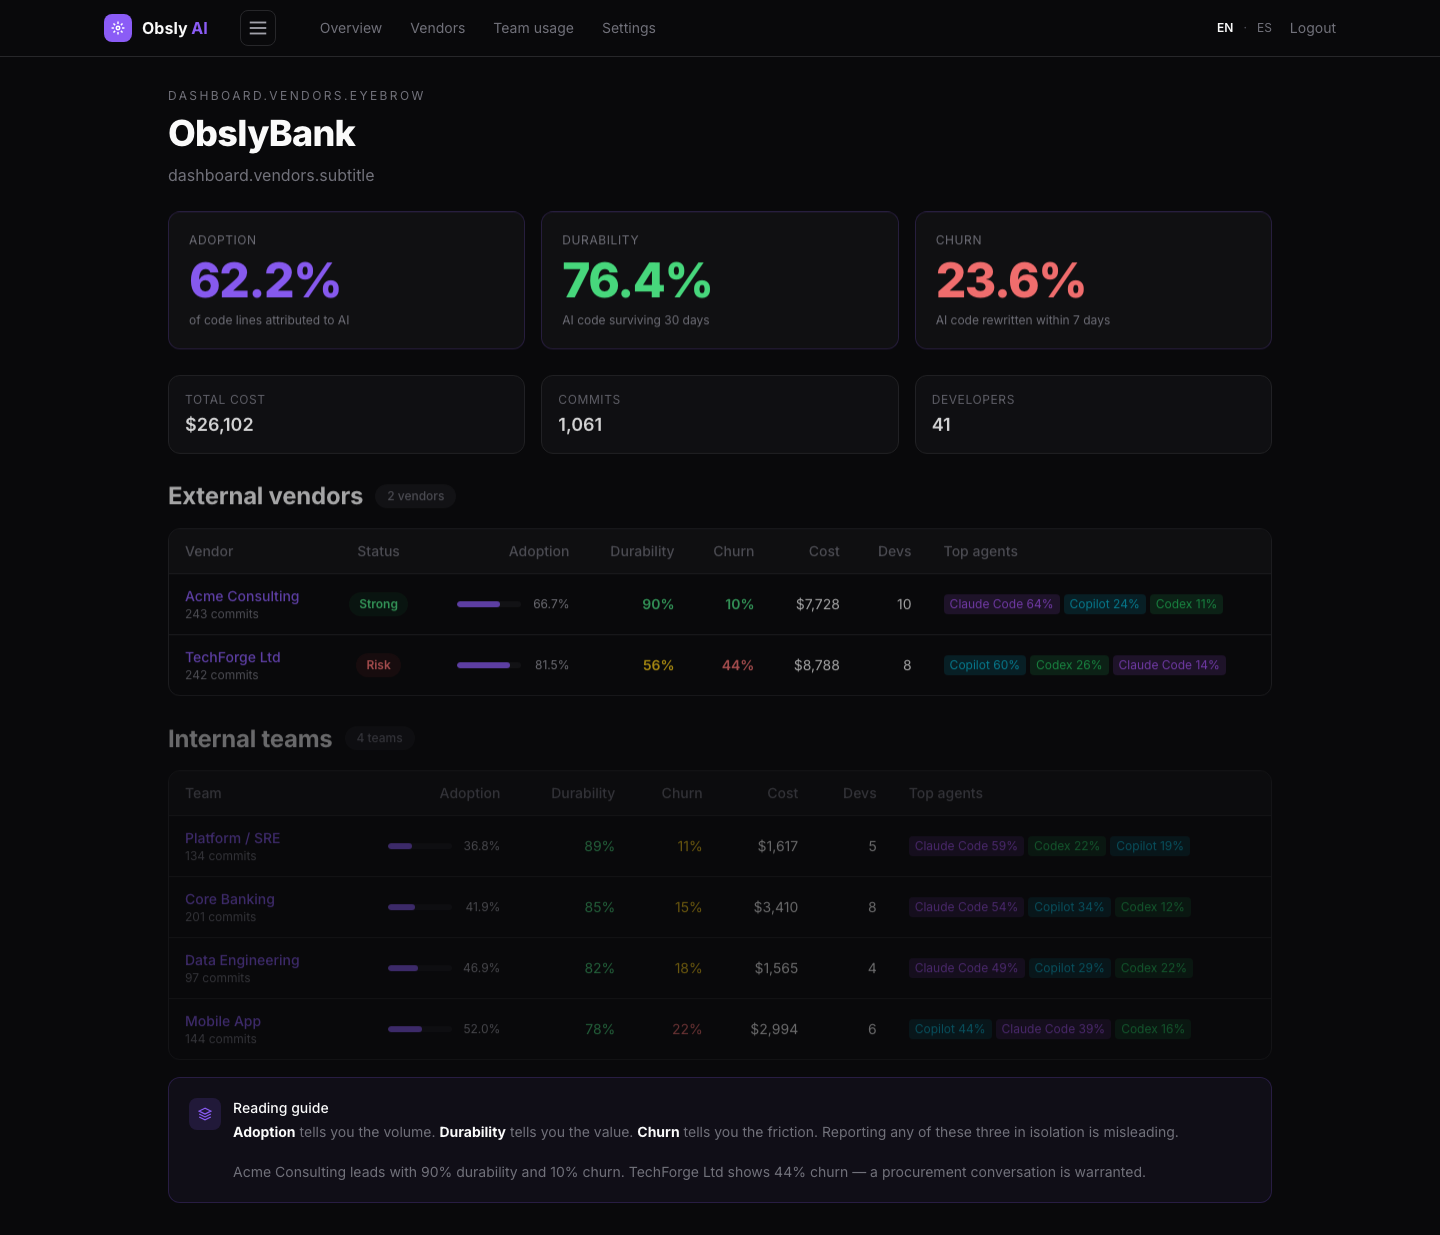
Figura 2: La misma empresa, dos proveedores, resultados diferentes (datos demo de IriaBank)
Sección 6
Camino de implementación
La observabilidad de código IA no requiere un nuevo SDLC. Es una capa añadida sobre los repositorios existentes sin alterar el flujo del developer.
- Semana 1 — Piloto en un solo repositorioInstala el CLI en las máquinas de tres ingenieros. Confirma que los hooks se disparan en cada commit. Valida que las git notes aparecen en
refs/notes/ai. - Semana 2 — Conecta el dashboardInstala la GitHub App. Verifica que los commits pusheados aparecen con su atribución. Establece el baseline de Adopción / Durabilidad / Reescritura de código para el repo piloto.
- Semanas 3–4 — Despliegue a un equipoOnboarding de un equipo de ingeniería completo. Compara métricas por developer en privado. Identifica patrones de alta Durabilidad y alta reescritura de código para hacer coaching.
- Mes 2 — Visibilidad por proveedorPara organizaciones con proveedores externos, invítalos como proveedores de datos. Establece una cadencia trimestral de revisión con los KPIs como agenda.
- Trimestre 1 — Report listo para boardPrimer report trimestral con tres números: Adopción, Durabilidad, Reescritura de código. Línea de tendencia. Comparativa de proveedores. El report que tu CFO lleva tiempo pidiendo.
Sección 7
Escenario ilustrativo
El siguiente escenario es ilustrativo y se basa en patrones observados en investigación de la industria 2026. Los nombres están anonimizados.
Un banco minorista europeo contrata a dos consultoras para entregar una nueva plataforma de banca móvil. Ambos proveedores cobran tarifas equivalentes por developer. Tras Q1, el equipo de procurement del banco solicita datos de atribución de código IA a ambos proveedores.
| Proveedor | Adopción | Durabilidad (30d) | Reescritura de código (7d) |
|---|---|---|---|
| Proveedor A | 68% | 91% | 4% |
| Proveedor B | 82% | 58% | 23% |
La lectura: El Proveedor B usa IA más agresivamente (82% vs 68%) pero produce código que se reescribe casi una cuarta parte del tiempo. El banco paga tanto la generación original como el retrabajo. El Proveedor A usa menos IA pero con resultados sustancialmente mejores.
La conversación que sigue: El banco no necesita rescindir al Proveedor B. Con estos datos, puede hacer preguntas concretas: qué agentes se están usando, en qué tipos de archivo, por qué equipos. Los datos convierten una preocupación vaga en una discusión estructurada de procurement.
Sección 8
Conclusión
Las herramientas de codificación IA no son el problema. La ausencia de medición lo es. Los presupuestos enterprise han crecido más rápido que los instrumentos para evaluar su retorno.
El framework propuesto en este paper es intencionadamente mínimo: tres KPIs, un estándar abierto, sin transmisión de código fuente. Complementa, no reemplaza, las plataformas de inteligencia de ingeniería existentes. Produce números que un CTO puede llevar a una reunión de board y un equipo de procurement puede llevar a una revisión de proveedor.
Las empresas que adopten esta capa en 2026 serán las que puedan responder, en doce meses, la única pregunta que importa: ¿la inversión en IA salió rentable?
Apéndice
El estándar abierto
Iria Monitor implementa la especificación git-ai v3.0.0, un estándar abierto para atribución de código IA almacenada como git notes en refs/notes/ai. El formato es legible por humanos, versionado, y portable entre herramientas.
Las organizaciones que adoptan el estándar conservan portabilidad total de datos. Si es necesario un cambio de herramienta por cualquier razón, los datos de atribución subyacentes son independientes de la plataforma analítica que los lea. Es el mismo principio que hizo de OpenTelemetry el estándar de facto para instrumentación de observabilidad: los datos sobreviven al proveedor.
Para la especificación técnica, ver github.com/git-ai-project/git-ai.
Referencias
Fuentes
- [1] Sonar Developer Survey 2026 & NetCorp, AI-Generated Code Statistics 2026. El 42% de todo el código es ahora generado o asistido por IA.
- [2] Anthropic, Claude Mythos Preview, abril 2026. 93,9% SWE-bench Verified; baseline de desarrolladores humanos 67–70%.
- [3] Sonar Developer Survey 2026 & NetCorp, AI-Generated Code Statistics 2026. El 42% de todo el código es ahora generado o asistido por IA.
- [4] Anthropic, Claude Mythos Preview, abril 2026. 93,9% SWE-bench Verified; baseline humano 67–70%. Análisis de benchmarks MindStudio.
- [5] GitHub Blog, Research: Quantifying GitHub Copilot's Impact with Accenture, 2025. Despliegue de 50.000 desarrolladores. 90% del Fortune 100 según Satya Nadella, julio 2025.
- [6] Lucidate, Goldman Sachs Scales AI Coding to Thousands of Agents, 2026. 12.000 desarrolladores, productividad 3–4x con ingeniero autónomo Devin.
- [7] Entrepreneur, Morgan Stanley Created an AI Tool That Saves Developers 280,000 Hours. DevGen.AI procesó 9M líneas de código en 15.000 desarrolladores en 5 meses.
- [8] Grand View Research & Precedence Research. Mercado AI code tools: $7,65B (2025), proyectado $26B (2030, 27% CAGR), $91B (2035).
- [9] GitHub Blog, Research: Quantifying GitHub Copilot's impact in the enterprise with Accenture, 2025. Despliegue de 50.000 desarrolladores; 84% más builds exitosas.
- [10] TechResearchOnline, Anthropic Enterprise AI Adoption Gains Momentum in 2026. 90% de adopción de Cursor en Salesforce; adopción de Claude Code en Microsoft.
- [11] AIX Network, Case Study: JPMorgan Chase AI. 200.000+ usuarios LLM Suite, inversión de $2.000M, 40–50% productividad en operaciones.
- [12] Lucidate, Goldman Sachs Scales AI Coding to Thousands of Agents, 2026. 12.000 desarrolladores, productividad 3–4x con Devin.
- [13] Entrepreneur, Morgan Stanley Created an AI Tool That Saves Developers 280,000 Hours. DevGen.AI, 9M líneas de código en 5 meses.
- [14] Banking Dive, Citi eyes AI productivity gains. 30.000 desarrolladores, 9% de mejora de productividad vía Google Cloud Vertex AI.
- [15] DefenseScoop, DOD initiates large-scale rollout of commercial AI models, diciembre 2025. GenAI.mil: 3 millones de usuarios.
- [16] DefenseScoop, DOD wants AI-enabled coding tools for developer workforce, febrero 2026. Requisitos FedRAMP High + IL5.
- [17] GOV.UK, AI coding assistant trial: UK public sector findings report, 2025. 50 organizaciones, 56 min/día ahorrados, 58% no volvería atrás.
- [18] Gartner, 80% of Governments Will Deploy AI Agents by 2028, marzo 2026.
- [19] Comisión Europea, EU AI Act. Aplicación completa 2 de agosto de 2026. Obligaciones de transparencia + compliance de sistemas de alto riesgo desde agosto 2027.
- [20] Virtuoso, Testing AI Generated Code in Regulated Industries, 2025. 29–48% debilidades de seguridad en código IA; implicaciones SOX/PCI DSS.
- [21] Baker Tilly, Evolving SOC 2 reports for AI controls, 2026. CC9.2 vinculado a integridad de modelo IA; 80% de resultados de auditoría dependen de calidad de evidencia.
- [22] Veracode, GenAI Code Security Report, 2025. Código IA tiene 2,74x más vulnerabilidades. 100+ LLMs probados en 4 lenguajes.
- [23] CodeRabbit, 2025 was the year of AI speed. 2026 will be the year of AI quality. 1,7x más incidencias en PRs con código IA (470 PRs analizados).
- [24] Anthropic, Claude Mythos Preview, abril 2026. 93,9% SWE-bench Verified (baseline humano 67–70%). MindStudio, Claude Mythos Benchmark Results.
- [25] Anthropic, Project Glasswing: Securing critical software for the AI era, abril 2026. Vulnerabilidad de 27 años en OpenBSD, fallo de 16 años en FFmpeg que sobrevivió 5M ejecuciones de tests. $100M en créditos comprometidos.
Construye tu capa de medición.
Iria Monitor es la implementación de referencia del framework descrito en este paper. Gratis para developers individuales. Por usuario para equipos. Custom para enterprise.
Ver el coach personal
Lleva el mismo marco al loop individual — local, leading, sin ranking.